Tadeusz Kifner, FOTO: P. Sudara
W naszym kraju powstają struktury wielkiej federacji cyfrowych danych medycznych. Docelowo będą miały fundamentalne znaczenie dla realizacji wizji medycyny spersonalizowanej i opartej na danych – opowiada o tym Tadeusz Kifner, stojący na czele Interdyscyplinarnego Pomorskiego Centrum Medycyny Cyfrowej (IP CMC).
Kilkakrotnie rozmawiałem z prof. Janem Poleszczukiem, badaczem i praktykiem wykorzystania danych w medycynie, który zawsze podkreślał, że bez uporządkowania procesu gromadzenia danych i zarządzania nimi mówienie o medycynie opartej na danych, sięganie po AI – nie ma sensu. Interdyscyplinarne Pomorskie Centrum Medycyny Cyfrowej idzie właśnie tą ścieżką: od architektury danych, przez nowe technologie, po AI. Przybliż proszę to przedsięwzięcie – to przecież nie jest odrębny szpital, tylko projekt?
To projekt realizowany przez wiele podmiotów w odpowiedzi na konkurs Agencji Badań Medycznych na budowę przestrzeni i rozwiązań do gromadzenia i przetwarzania danych medycznych. W całym kraju działa 19 takich jednostek. Każda trochę po swojemu, ale wszystkie próbują zbudować docelową strukturę informatyczną i badawczą.
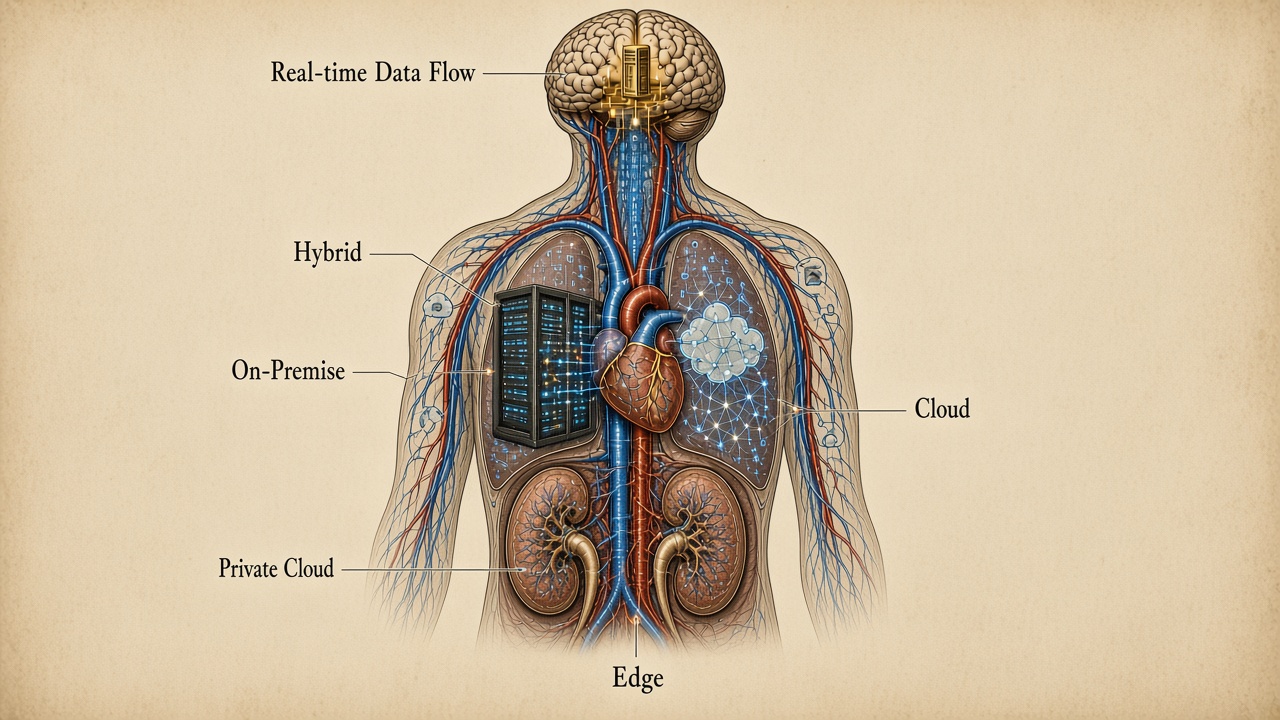
W ramach projektu budujemy różne środowiska, w tym chmurowe. Tworzymy miejsce, do którego dane mogą być transferowane ze szpitala – nie tylko z gdańskiego Uniwersyteckiego Centrum Klinicznego, które jest dziś jednym z partnerów naszego projektu, ale z każdego, który zechce się podłączyć i uzna, że współpraca ma sens. Zapewniamy pełne zaplecze informatyczne dla badaczy. Chcemy, żeby nasze centrum było dla nich oknem na świat i żeby nie musieli, jak dziś bardzo często, przebijać głową muru.
Jak wygląda organizacja takiego przedsięwzięcia?
Wielkość wyzwania przed jakim stoimy działa niestety na niekorzyść niektórych ośrodków, bo nie zawsze mają doświadczenie w łączeniu obszaru medycznego, czyli najczęściej uniwersytetu medycznego, z częścią kliniczną, a do tego jeszcze wkomponowania technologii informatycznej. U nas wsparcie technologiczne udziela Politechnika Śląska i Uniwersytet Gdański. Środowisko projektowe, jak pamiętam z projektów w bankowości, było bardziej homogeniczne: jeden dostawca, dwóch, ale zawsze relacja jeden do jednego albo jeden do wielu. Tutaj jest każdy z każdym. Jako lider projektu tworzymy pewne podstawy i tak naprawdę mamy do czynienia ze wszystkimi. Działa siatka powiązań.
W ramach projektu budujemy wsparcie dla naszych laboratoriów. Mamy ich obecnie kilkanaście i są to laboratoria wirtualne, często korzystające z pracy zdalnej. Na czele laboratorium stoi zazwyczaj osoba merytoryczna z ugruntowanym dorobkiem naukowym, która bierze w swoje ręce pomysły i próbuje je zwalidować, sprawdzić, czy mają sens. To typowa praca badaczy, która kończy się artykułem naukowym. Teraz badacze mają lepsze wsparcie technologiczne i nie muszą szukać go na zewnątrz uczelni.
Chodzi o połączenie dwóch światów. My – IT – nie znamy się na medycynie, a lekarz podobnie nie zna się na informatyce, choć są wyjątki. My, jako centrum, mamy nakręcić sprężynę, z której będzie można wystrzeliwać pomysły badawcze i dawać szansę ich zrealizowania w laboratoryjnym środowisku.
Często dostajemy dane, obrabiamy je po drodze, przygotowujemy, a potem badacze na tych danych szukają i „kopią” informacje. To dane historyczne, ale możemy też tworzyć dane „z przyszłości” lub syntetyczne, łącząc różne źródła albo tworząc nowe.
Ciekawostką jest to, że będziemy próbowali stworzyć środowisko do monitorowania pacjenta pooperacyjnego i kondycji pacjentów z klinik. Chodzi nam o wykrywanie symptomów kryzysów i zapaści albo zapobieganie zachowaniom, które mogą pacjentowi zaszkodzić, na przykład omamom po wybudzeniu z operacji albo pogorszeniu parametrów życiowych, które obserwujemy na żywo. Dzięki badaniom w centrum szpital pozyska narzędzia, które go nadzorują, oczywiście po uzyskaniu jego zgody. Mogą pokazać na przykład, że pacjent z 80-procentowym prawdopodobieństwem wpadnie we wstrząs, co daje szansę lekarzowi uprzedzenia takiego zdarzenia. W przyszłości można też myśleć o przeniesieniu takich badań do środowiska domowego i wykorzystaniu urządzeń przenośnych, tzw. wearables.
To wszystko jest ciekawe i ma potencjał, ale trzeba udowodnić, że działa. I właśnie po to są badania naukowe. Nie chodzi o to, że ktoś założy firmę i powie, że ma pomysł. Mówimy o wyrobach medycznych, które mają konkretne zadanie do wykonania. Nie może być tak, że ktoś ogłasza, że jego rozwiązanie działa bez walidacji – musi to wykazać w odpowiednim środowisku, a centrum medycyny cyfrowej ma właśnie takie środowisko oferować.
Jak ta powstająca struktura wygląda w porównaniu z innymi krajami? Czy istnieje jakieś ciało nadrzędne, które te podmioty koordynuje?
Tak naprawdę w polskich realiach nikt nie wiedział, jak to zrobić. U nas powstała sieć ośrodków Regionalnych Centrów Medycyny Cyfrowej w najważniejszych ośrodkach akademickich i klinicznych w Polsce, która wytycza ścieżki i sposoby współpracy naukowej. Są oczywiście przykłady z krajów ościennych. Ale my po prostu jesteśmy inni, i to nie tylko z przyczyn procesowych, lecz także kulturowych, więc nie dążymy do skopiowania jakiegoś zagranicznego wzorca.
W Wielkiej Brytanii powstały na przykład regionalne huby i wyspecjalizowane platformy dziedzinowe i tematyczne, do których trafiają na przykład wszystkie badania onkologiczne czy genomiczne. Dzięki temu można pracować na pełnym zbiorze danych wszystkich pacjentów.
U nas nie da się wdrożyć platform dziedzinowych i zmusić wszystkich, żeby przesyłali dane w jedno miejsce. Każdy ma własną politykę wewnętrzną, a między ośrodkami występuje pewna rywalizacja. Trzeba to powiedzieć głośno: mamy rozbicie dzielnicowe.
Wynika ono także z tego, że prowadzone badania są bardzo unikalne. Jeśli ktoś pracuje nad czymś cztery, pięć lat, to stara się je
chronić. Gdyby ktoś nagle nakazał z góry, żeby wszystko przekazać na drugi koniec Polski, nie byłoby to najlepsze rozwiązanie.
Tym bardziej że finansowanie jest konkursowe.
Tak. Ideą agencji było, żeby z tego złożyć federację i umiejscowić gdzieś nad tym ciało pełniące rolę „wspólnych drzwi”, żeby dane można było wymieniać. Na razie tworzymy ośrodki lokalne i regionalne, jest ich 19. Czy wszystkim tak samo dobrze się powiedzie – nie wiem, bo są problemy typowo techniczne, projektowe i organizacyjne. To naprawdę trudny projekt.
Wróćmy do podstawowej kwestii danych.
Mamy ich bardzo dużo. Gdyby połączyć dane ze wszystkich ośrodków, powstałaby największa baza danych w Polsce, więc poligon doświadczalny jest ogromny. Przewidujemy, że będziemy przetwarzać bazę obiektową w rozumieniu data lakehouse – połączenie danych strukturalnych i niestrukturalnych.
To oznacza uwzględnienie wartości danych historycznych, które trudno uporządkować wstecznie.
Teoretycznie tak, ale sam sposób przetwarzania tych danych nie jest strukturalny. Jeśli mamy dane genomiczne, to są to po prostu duże pliki i one same się nie poukładają. Badania mają różną jakość i dojrzałość, zależną od tego, kiedy zostały wykonane – znaczenie ma choćby to, jak szybko próbka trafi do laboranta i jaką czystość gwarantuje, jaką rozdzielczość miała maszyna wykonująca badanie. Zdarza się przykładowo, że nieodpowiednia procedura ekstrahowania genomu człowieka prowadzi do błędnych wniosków i wychodzi nam gen muchy, bo nastąpiło zanieczyszczenie próbki. To środowisko danych nie jest więc ani proste, ani klarowne.
Planujemy zbudować bazę rzędu około jednego petabajta w każdym ośrodku na start. Prawdopodobnie będzie to rosło, bo nowe maszyny i urządzenia generują coraz większe pliki medyczne i mamy dodatkowe dane do przetworzenia.
Nie uwzględniamy w tym jednak praktycznie danych historycznych – stare zdjęcia rentgenowskie leżą na kliszach, nikt ich nie skanował, a miałyby wartość naukową. Dawniej oczywiście badania były technicznie mniej dokładne, ale w połączeniu z bieżącymi danymi ukazałyby postępy choroby co byłoby przydatne badaczom. Nie ma jednak projektu, który sfinansowałby zeskanowanie prześwietleń sprzed 10 czy 20 lat. Gdyby taki projekt się pojawił, ilość danych byłaby ogromna. Łącznie z naszych centrów medycyny cyfrowej mogłoby to być 40–50 petabajtów, i to danych różnorodnych, a nie powtarzających się.
To naprawdę ogromny zbiór, dziś zarządzany w sposób rozproszony, bo każdy ośrodek ma swój kawałek. Pracujemy nad tym, żeby te elementy połączyć, czyli zrobić federację. Jako architekt nie wierzę w przetwarzanie tego w jednym miejscu. Takie bazy realnie nie istnieją w postaci, którą można odpytywać, bo pojawiają się kwestie wydajnościowe, a do tego cała logistyka aktualizowania, dodawania i usuwania danych. Czasem pacjent chce zostać usunięty albo rodzina może się sprzeciwić wykorzystaniu jego danych po śmierci do celów naukowych. Ma do tego prawo. Szpital wtedy jest zmuszony zaktualizować rekordy przekazane anonimowo do centrum. Do rozwiązania mamy też kwestię przekazywania danych między ośrodkami bez przekazywania numeru PESEL i bez ryzyka reidentyfikacji rekordu.
Czyli powstaje pewien model architektury, który mógłby być wspólnie wykorzystywany w regionalnych bazach, a jednocześnie warstwa dostępu dla badaczy, którzy nie mają być informatykami, tylko użytkownikami – z interfejsem i wspólnymi narzędziami dostosowanymi do baz o wystandaryzowanej architekturze.
Tak, to kilka warstw. Pierwsza to, mówiąc obrazowo, przelewanie dużej ilości danych z małych zbiorniczków do jednego dużego zbiornika, którym będzie regionalne centrum medycyny cyfrowej. Badaczowi musimy dać do tego dostęp, ale nie powinien przeglądać całego „jeziora” – po co mu wszystkie informacje? To cel badawczy, a nie demograficzny. Badacz stawia na przykład tezę badawczą, że istnieje korelacja między białaczką a poziomem witaminy D we krwi, i wtedy zarzuca sieć w to „jezioro”, wyławiając pacjentów spełniających zapytanie – do konkretnego badania. Znane z Data Science nurkowanie w dane występuje tylko na poziomie kohorty, a nie całej bazy.
W obecnym środowisku każdy badacz ma swój duży szpital, z którym współpracuje, i w jego ramach próbuje pozyskiwać kohorty danych. To niewystarczające, żeby obronić tezę na dużej próbie statystycznej, więc i tak trzeba będzie łączyć dane z wielu źródeł.
Po to są centra medycyny cyfrowej: żeby połączyć różne jeziora danych w jeden zbiornik i łowić z niego większą próbę. Ma to kolosalne znaczenie dla przypadku chorób rzadkich, kiedy mówimy o 10 czy 20 przypadkach w województwie. Żeby zrobić próbę badawczą, trzeba połączyć nie tylko wszystkie województwa, ale pewnie i dwa, trzy kraje ościenne.
Kierujemy się pięcioma zasadami: jeden punkt wejścia, żeby badacz nie musiał otwierać różnych baz danych; wspólny standard widoku na dane, bo dziś każda baza jest inna – mamy czterech największych dostawców szpitalnych systemów informatycznych, a nasze 19 ośrodków korzysta z różnych systemów HIS; zgodność z bioetyką i prawem, bo badacz musi uzyskać odpowiednie zgody, a nie każdy może oglądać wszystkie dane; bezpieczeństwo, czyli normy zewnętrzne, audyty, przeglądy i certyfikacje; i wreszcie trwałość – zakładamy, że to, co budujemy, będzie działać 10, 20 lat, a może dłużej. Agencja kończy finansowanie tych konkursów w 2028 roku, ale to nie koniec, tylko początek. Inne kraje zaczęły dużo wcześniej i nas mocno wyprzedzają.
Dobrym przykładem jest brytyjski UK Biobank, w którym zgromadzono dane genetyczne pół miliona osób. To największa baza, którą można wykorzystywać do bieżących badań. Wystarczy złożyć wniosek i przejść walidację, co jest dużo prostsze niż samodzielne wykonywanie takich badań. Pełny genom w najtańszej wersji to kilka tysięcy złotych, więc jest o co walczyć.
Wspomniałeś o chorobach rzadkich i łączeniu baz z kilku krajów. Na ile to zaawansowane, zaplanowane?
Jeśli chodzi o wymogi prawne, jesteśmy w przededniu pełnego wdrożenia EHDS, czyli Europejskiej Przestrzeni Danych Dotyczących Zdrowia, które jest wdrażane etapami.
Rok 2027 to start przepisów ustrojowych – organy do spraw dostępu do danych, katalogi zbiorów, akty wykonawcze. Realne obowiązki przychodzą w 2029. W użyciu pierwotnym obejmują kategorie priorytetowe. W użyciu wtórnym, a więc w tym, czym zajmuje się centrum medycyny cyfrowej, wchodzi wtedy większość katalogu danych – razem z obrazowaniem: tomografią, rentgenem, USG. Trzeba tu podkreślić, że my nie przetwarzamy danych identyfikowalnych pacjentów, tylko zanonimizowanych: pacjent jest dla nas cyfrowym bytem, który występuje w badaniu i procedurze medycznej. Dane genomiczne i omiczne od 2031 roku. Z innymi krajami, przez wspólną infrastrukturę HealthData@EU, będziemy musieli się połączyć około 2029 roku.
Na jakim etapie są inne kraje i jakie obrały modele?
W Niemczech jest sieć uniwersyteckich szpitali, które stworzyły wspólne standardy wymiany danych oparte na tym samym skrócie, którego my używamy: FHIR.
Francuzi mają Health Data Hub, czyli jeden punkt wejścia; dane nie zawsze są zbierane fizycznie w jednym miejscu, tylko udostępniane w formie usługi, dzięki której masz dostęp do przestrzeni, gdzie przechowywane są informacje o pacjentach, zgodnie z zasadami etyki i bezpieczeństwa.
Model dzieli się na usługi dla profesjonalistów oraz dla obywateli; u nas odpowiednikiem tych drugich jest Internetowe Konto Pacjenta. Nasze podejście przy usługach dla profesjonalistów ma dodatkowe elementy związane z wtórnym użyciem danych, budowane równolegle, więc to nie jest przeniesienie modelu francuskiego jeden do jednego.
Finlandia ma z kolei jedną bramę i jedną zgodę, o którą występuje badacz: żeby dostać się do danych, gdziekolwiek leżą, trzeba przejść przez odpowiednią bramkę decyzyjną. To podejście federacyjne – wiadomo, gdzie dane leżą, a ja mam „klucz dostępu”.
Uważam, że w Polsce powinniśmy wziąć sobie ten model do serca. Budowanie w ochronie zdrowia wielkich serwerowni i zrzucanie wszystkiego do jednego worka to przepalanie pieniędzy.
Nie widziałem w Polsce serwerowni, która operacyjnie obsługiwałaby 40-50 petabajtów spójnych struktur danych medycznych w różnych, często dziwnych formatach – wymagałoby to masy ludzi. Rozsądniej ekonomicznie jest zrobić to w modelu federacyjnym.
Tym bardziej że mamy do tego podstawy, na przykład w podobnej do holenderskiej warstwie „data holders”, czyli podmiotów przechowujących dane, i portali, przez które można je znaleźć. W Stanach Zjednoczonych był program z milionem uczestników, a w Wielkiej Brytanii jest pół miliona – dla badacza to jak rozsiąść się wygodnie w fotelu i mieć dostęp do wszystkiego od ręki.
Gdzie w tej strukturze są dane z monitorowania pacjentów?
To dwa różne środowiska. W szpitalu pacjenta monitoruje się na bieżąco, ale muszę powiedzieć, że większość tych danych jest tracona – to duży problem. Wynika on z tego, że samo ściągnięcie danych z monitorów jest dla szpitala ogromnym kosztem, płaci się za poszczególne połączenia, więc się to po prostu nie opłaca. Do podstawowego celu, czyli sprawdzenia, czy z pacjentem wszystko jest w porządku, wystarcza to, co widać na monitorze w dyżurce – nie ma scenariusza użycia dla nagrywania tego wszystkiego, a w służbie zdrowia musimy ograniczać koszty.
Są też urządzenia podłączane na jakiś czas, na przykład aparaty holterowe czy sondy mierzące poziom glukozy. Te dane również nie są zbierane systemowo, tylko jako pliki dołączane do kartoteki – lekarz zrzuca je gdzieś na bok, ma pewnie jakiegoś Excela. Jeśli z pomocą naszego centrum połączymy różne źródła, to może próbować zbudować retrospektywny obraz pacjenta z wielu plików. Szpital ma wiele takich podsystemów, które mają wartość naukową, ale na razie nie ma przypadku użycia i nikomu do końca nie zależy na ich systematycznym zbieraniu.
Lekarze rodzinni, niepowiązani z badaniami, zbierają dane do diagnozy, trzymają je miesiąc, dwa, trzy, a potem kasują, bo do ich konkretnej pracy są niepotrzebne. To duża biała plama i szansa na przyszłość – monitory i urządzenia noszone przez pacjentów mogłyby zasilać taką bazę, zwłaszcza w przypadku osób starszych, których nie będziemy trzymać w szpitalu, tylko w domu. Dobrze byłoby to wdrożyć, ale musiałby się znaleźć sponsor. Dziś pacjenci sami prowadzą swoje repozytoria badań, szczególnie gdy korzystają z usług różnych ośrodków medycznych. Ewidentnie gubimy wiele ciekawych rzeczy, podobnie jak z kliszami RTG. Swoje przez jakiś czas trzymałem, ale dziś nie wiem, czy jestem w stanie dobrać się do badań sprzed 10 lat.
Powstaje więc potencjał do nowych scenariuszy użycia. Na ile badacze są w stanie wytworzyć masę krytyczną, żeby na przykład dane z monitoringu wykorzystać, i jakich zasobów do tego potrzeba?
To dzieje się niejako organicznie. Jeśli badacz chce dostać dane z inkubatorów dziecięcych, okazuje się, że wcale nie jest to trywialne – musi sam zagwarantować całą infrastrukturę w swoim projekcie. Projekt badawczy, który miałby badać noworodki, zamiast skupiać się na nauce musi zakupić całą infrastrukturę informatyczną, a to często „rozkłada” finansowo projekt naukowy.
Badanie przesiewowe, kiedy już mam wszystkie narzędzia, byłoby w miarę tanie. Jeśli dorzucimy pełny komponent teleinformatyczny (architektura, systemy, ludzie, infrastruktura ze wsparciem), z miliona złotych robi się 10-20 milionów – to inny rząd wielkości kosztów, który nagle się pojawia, i takie projekty nie mają szansy zaistnieć.
Centra medycyny cyfrowej mają między innymi spowodować, że badacz nie będzie musiał za każdym razem budować własnego serwera i infrastruktury, tylko wykorzysta to, co już istnieje.
Dam przykład: robimy badania mikroskopem, który potrafi powiększyć obraz 100 czy nawet 1000 razy, więc widać poszczególne komórki czy struktury subkomórkowe, i to w różnych kolorach światła – w jednym widać komórki nowotworowe, w drugim znikają. Takie zdjęcie w wysokiej rozdzielczości waży 30 GB, a potrzeba trzech naraz, żeby je nałożyć jedno na drugie i policzyć komórki zdrowe i nowotworowe. To ogromna ilość informacji, do której zwykłe komputery nie wystarczają, bo potrzebujemy dużo większej mocy obliczeniowej niż daje standardowa karta graficzna. Dlatego zajmujemy się też w Gdańsku superkomputerami z przemysłowymi GPU i realizujemy projekt razem z krakowskim Cyfronetem, gdzie te obliczenia prowadzone są na dużym komputerze. Okazuje się, że ośrodek medycyny cyfrowej to ciekawe miejsce pracy, bo za każdym razem uczymy się czegoś nowego i dotykamy technologii, o której wcześniej nie pomyślałbym, że będę się nią zajmować.
Skąd rekrutujecie badaczy? Czy część z nich ma podwójną afiliację – jest w ośrodku, a jednocześnie w jakiejś innowacyjnej firmie?
To dwa obozy, ale nie przeciwstawne: badania komercyjne i niekomercyjne. Firma z sektora biotechnologicznego czy farmaceutycznego może mieć tyle pieniędzy, że prowadzi własne, zamknięte badania, wykonywane razem z lekarzami. Wyniki są przynajmniej przez jakiś czas zarezerwowane dla firmy. Większość stanowią jednak badania niekomercyjne.
Mówiąc wprost, wszystko, co finansuje NFZ, tworzy zbiór, który może być dostępny dla badań naukowych. Wykorzystanie danych do użycia wtórnego nie wymaga indywidualnej zgody pacjenta – wynika to z unijnych przepisów mówiących o celu wyższym. Dane muszą być zanonimizowane, bezpieczne i gwarantować pacjentowi, że nie będzie z tego powodu piętnowany, a warunki bezpieczeństwa muszą być zapewnione wspólnie dla całej sieci jednostek medycznych w kraju, nie tylko dla jednego centrum. Od 2029 roku EHDS nada temu wspólne ramy w całej Unii, łącznie z prawem pacjenta do sprzeciwu.
Dziś małe szpitale robią to po swojemu, duże po swojemu, a uniwersytety jeszcze inaczej. CMC jest gdzieś pośrodku i ma dać przykład dobrej praktyki, tak żeby każdy robił to w miarę sensownie tworząc warunki, w których każdy będzie chciał przyjść do CMC, bo będzie mu łatwiej.
Możliwe, że w przyszłości realizowane będą tu także badania komercyjne, ale na razie konkurs ma swój konkretny zakres i w nim działamy. Oczywiście martwię się o zarabianie pieniędzy – skończą się konkursy, a ja muszę utrzymać ludzi – ale to pieśń przyszłości.
Kwestia fundamentalna: teraz to grant, ale jak taka struktura miałaby funkcjonować potem?
Projekt się nie skończy tak po prostu. Każdy z tych uniwersytetów wie, że to przewaga konkurencyjna – jako uczelnia badawcza ma większe szanse na wyższe ratingi, więc na pewno będzie chciał utrzymać te ośrodki także po konkursie.
Sposób finansowania pewnie będzie musiał się zmienić – podejrzewam, że część kosztów poniesie uniwersytet, bo będzie miał z tego zysk w postaci wartości ratingowej i większej liczby publikacji. Poza tym po projekcie trzeba utrzymać infrastrukturę, bo obowiązuje okres trwałości.
Z drugiej strony badaczy jest sporo. Nakręcamy tę sprężynę, namawiając ich do współpracy i dając szansę wspólnej pracy. Będą chcieli do nas przychodzić, bo mają jeden punkt styku, jeden standard, wsparcie merytoryczne i techniczne, które musieliby zdobywać na zewnątrz. Do tej pory też mieli środki na informatykę, ale były rozproszone – teraz wystarczy je skomasować. Jeśli badacz pisał we wniosku, że kupi serwer, teraz napisze, że skorzysta z usług centrum medycyny cyfrowej. Jest więc szansa, żeby połączyć pewne rzeczy w coś na kształt centrum usług wspólnych – wiem, że tylko „na kształt”, bo z biznesu nie da się tego przenieść jeden do jednego, jest jeszcze prawo zamówień publicznych i tak dalej, ale schemat myślenia wydaje się dobry.
Kiedy inne kraje zaczęły to robić, nikt się z tego nie wycofał. EHDS jest narzucony z góry, więc na pewno musi powstać federacja, która będzie zarządzać dostępem do tych danych. W 2030 roku nie tylko Warszawa czy Wrocław zwrócą się do Gdańska o dane, ale także Berlin, Lizbona albo inny kraj Unii Europejskiej – przestrzeń danych do celów naukowych będzie otwarta i musimy być na to gotowi. Pewnie na początku każdy będzie bronił swojego, podobnie jak przy wprowadzaniu open bankingu w sektorze finansowym, kiedy też pytano, co będzie, skoro wszyscy będą widzieć wszystko. Minęło od tego pomysłu chyba dziesięć lat, banki nie narzekają, wręcz widzą w tym zysk. Będzie okres przejściowy, a potem przyzwyczaimy się i będzie dobrze działać.
Jaki profil informatyków przyciąga taki projekt? Jak się w nim odnajdujesz osobiście po karierze w sektorze finansowym?
Ciekawe, że dostawcy są dokładnie ci sami co w bankowości – zamiast fintechów mamy medtechy, zmienił się tylko przedrostek. Informacje są rozrzucone, to wyzwanie, a czasem trzeba budować pewne rzeczy od podstaw. Centrum medycyny cyfrowej sami wymyśliliśmy, wzorując się na innych. Dla mnie osobiście to świetne doświadczenie pracy przy wersji 1.0, a nie którejś kolejnej, tu nie ma ani spokoju, ani powtarzalności, bo każdego dnia dowiadujemy się czegoś, co może wywrócić wiele rzeczy do góry nogami. Są informatycy, którzy właśnie tego szukają.
I ja szukałem trochę takich „wariatów” do pracy, niekoniecznie dla pieniędzy, bo to jednak administracja i pensje są niekonkurencyjne wobec biznesu. Są jednak inne benefity, które to rekompensują – możliwości rozwoju zawodowego, szkoleń i wyjazdów, na co w typowym biznesie nikt by nie wpadł. Tutaj jest to naturalne, bo to środowisko naukowe, gdzie należy się rozwijać, a nie wyciskać cytrynę.